Python SERP API 教學:使用 TalorData 取得 Google 搜尋結果 JSON 資料
學習如何使用 Python 呼叫 SERP API 取得結構化 Google 搜尋結果 JSON 資料。透過 TalorData 建立 SEO 工具、AI Agent 與搜尋資料應用,不需要維護複雜搜尋爬蟲系統。


如今,越來越多的應用程式需要即時搜尋數據。
SEO 平台需要獲取最新的關鍵字排名資訊,AI Agent 需要存取即時網路資訊,市場分析系統需要持續監控競爭對手和行業趨勢。
但是,獲取搜尋引擎數據並不像向 Google 發送 HTTP 請求並解析 HTML 那麼簡單。
搜尋結果是動態變化的,並且受到多個因素影響:
● 地理位置
● 語言設定
● 裝置類型
● 搜尋時間
● 搜尋特徵
對於需要大規模使用搜尋數據的開發者來說,長期維護自建爬蟲系統會變得越來越複雜。
SERP API 提供了一種更穩定的解決方案:
開發者無需自己解析搜尋頁面,而是透過 API 介面直接獲取結構化搜尋結果。
本文將介紹如何使用 Python 呼叫 TalorData SERP API,獲取 Google 搜尋結果 JSON 數據,並建構基於搜尋數據的應用。
你將學習:
● 如何使用 Python 發送第一個 SERP API 請求
● 如何獲取結構化 Google 搜尋結果
● 如何控制地區和語言參數
● 如何處理分頁搜尋
● 如何建構 SEO 和 AI 搜尋工作流程
● 如何避免傳統搜尋爬蟲的常見問題
什麼是 SERP API?
SERP 是 Search Engine Results Page(搜尋引擎結果頁面)的縮寫。
SERP API 是一種允許開發者透過介面存取搜尋結果數據的技術。
傳統方式:
搜尋引擎
↓
HTML 頁面
↓
解析程式
↓
提取數據
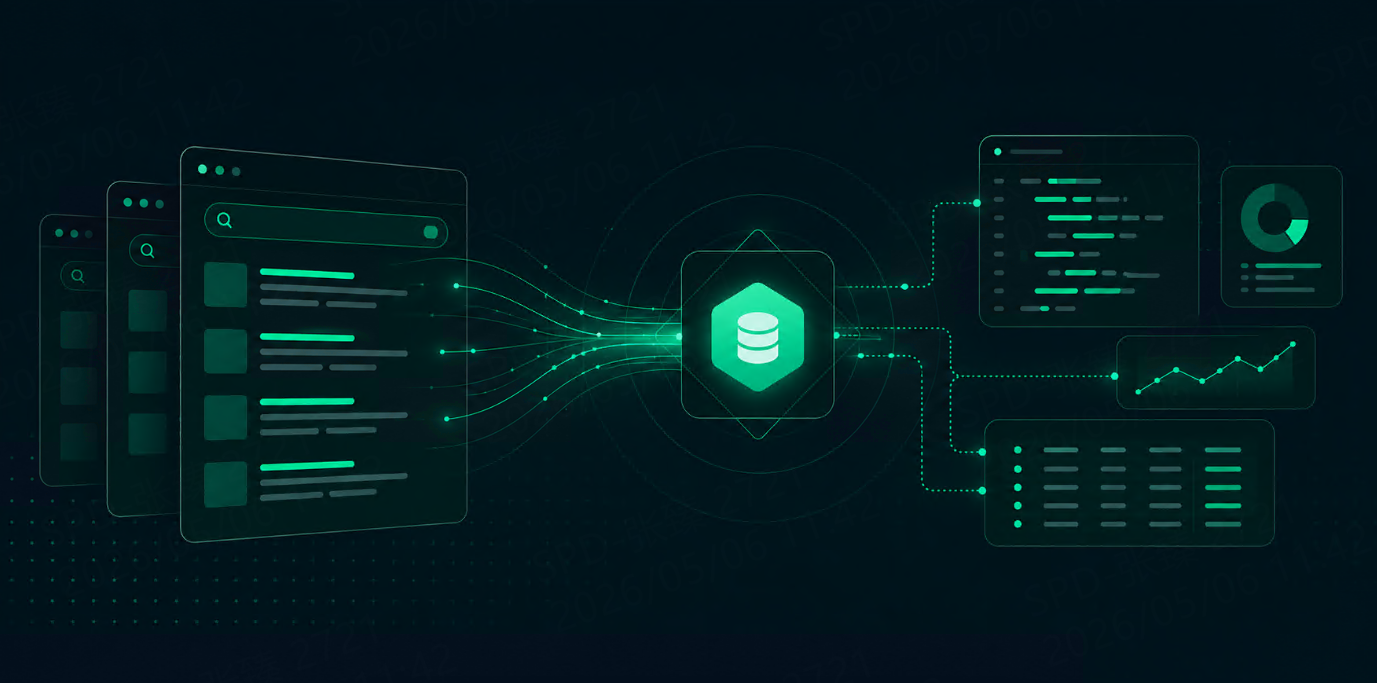
使用 SERP API:
應用程式
↓
SERP API
↓
JSON 數據
↓
業務邏輯
例如,傳統方式需要從 HTML 中提取:
● 標題
● URL
● 描述
● 排名位置
而 SERP API 會直接返回結構化數據:
json
{
  "organic_results": [
    {
      "position": 1,
      "title": "Example Result",
      "link": "https://example.com"
    }
  ]
}
開發者可以直接使用這些欄位,而無需維護複雜 HTML 解析邏輯。
為什麼選擇 SERP API,而不是直接爬取 Google?
傳統網頁爬蟲在很多場景中非常有用,例如:
● 產品頁面採集
● 內容分析
● 網站數據提取
但是搜尋引擎數據有其特殊性。
1. HTML 結構不斷變化
很多爬蟲依賴 CSS Selector:
python
title = soup.select_one(".result-title")一旦頁面結構改變:
● 選擇器失效
● 解析邏輯需要更新
● 程式可能無法運行
SERP API 將這些變化封裝在介面層,返回穩定的數據結構。
2. 搜尋結果依賴上下文
Google 搜尋結果不是固定的。
同一個關鍵字,根據:
● 國家
● 語言
● 裝置
可能得到完全不同的結果。
例如:
best AI tools
美國、日本、德國用戶看到的排名可能不同。
SERP API 可以讓開發者控制這些搜尋環境。
3. 瀏覽器自動化成本較高
很多開發者嘗試:
● Selenium
● Playwright
● Headless Chrome
這些方案需要額外維護:
● 瀏覽器環境
● 代理
● 驗證機制
● 伺服器資源
對於需要穩定擴展的應用,API 通常更加簡單。
SERP API 的應用場景
SERP API 適用於需要搜尋數據的應用。
SEO 工具
SEO 平台通常需要:
● 關鍵字排名
● 競爭分析
● SERP 變化監控
典型流程:
關鍵字列表
↓
SERP API
↓
排名數據
↓
SEO Dashboard
AI Agent
AI 應用需要即時資訊。
語言模型本身存在知識截止時間,而搜尋 API 可以連接即時網際網路。
架構:
用戶
↓
AI Agent
↓
TalorData SERP API
↓
搜尋結果
↓
AI 分析
↓
回答
應用場景:
● AI 搜尋助手
● 企業知識系統
● 自動化研究工具
開始使用 TalorData SERP API
開始之前,你需要:
- TalorData 帳號
- API Token
- Python 環境
API Token 用於驗證請求。
建議不要直接寫入程式碼。
設定 Python 環境
安裝 requests:
bash
pip install requests安全保存 API Token
不要:
python
API_TOKEN = "your_token"推薦:
python
import os

API_TOKEN = os.getenv(
    "TALOR_API_TOKEN"
)
設定環境變數:
macOS / Linux:
bash
export TALOR_API_TOKEN="your_token"Windows:
cmd
setx TALOR_API_TOKEN "your_token"第一個 Python SERP API 請求
範例:
python
import os
import requests

api_token = os.getenv(
    "TALOR_API_TOKEN"
)

url = "https://serpapi.talordata.net/serp/v1/request"

headers = {
    "Authorization": f"Bearer {api_token}"
}

payload = {
    "engine": "google",
    "q": "python serp api"
}

response = requests.post(
    url,
    headers=headers,
    json=payload
)

results = response.json()

print(results)
請求返回的數據包括:
● 搜尋結果
● 標題
● URL
● 描述
● 排名位置
解析 SERP API 返回數據
範例:
json
{
  "organic_results": [
    {
      "position": 1,
      "title": "Example",
      "link": "https://example.com"
    }
  ]
}
Python 提取:
python
for item in results["organic_results"]:
    print(
        item["position"],
        item["title"]
    )
進階搜尋參數
SERP API 最大優勢之一,是可以控制搜尋環境。
地理位置
json
{
  "location": "United States"
}
適用於:
● 本地 SEO
● 國際市場分析
● 區域搜尋研究
搜尋語言
json
{
  "hl": "de"
}
適用於:
● 多語言 SEO
● 全球內容研究
裝置類型
json
{
  "device": "mobile"
}
用於分析:
● 行動端排名
● 不同裝置搜尋差異
Google Images
json
{
  "tbm": "isch"
}
Google News
json
{
  "tbm": "nws"
}
使用 Python 建構 SEO 排名追蹤工具
SERP API 最常見應用之一,就是關鍵字排名監控。
流程:
關鍵字
↓
SERP API
↓
排名數據
↓
資料庫
↓
分析 Dashboard
例如:
python
keywords = [
    "python serp api",
    "google search api"
]
系統可以:
- 查詢關鍵字
- 查找目標網站
- 獲取排名
- 保存歷史變化
使用 SERP API 建構 AI Agent 搜尋能力
現代 AI Agent 越來越依賴即時數據。
SERP API 可以讓 Agent:
● 獲取最新資訊
● 驗證來源
● 搜尋資料
● 生成研究報告
架構:
用戶
↓
AI Agent
↓
TalorData SERP API
↓
即時搜尋結果
↓
LLM
↓
最終回答
最佳實踐
保護 API Token
不要:
● 提交 GitHub
● 暴露前端程式碼
● 寫死在程式中
使用:
● 環境變數
● Secret Manager
保存歷史數據
搜尋結果會變化。
保存歷史 SERP 數據可以分析:
● 排名變化
● 競爭趨勢
● 市場變化
常見問題 FAQ
Python 可以抓取 Google 搜尋結果嗎?
可以。
但需要處理:
● HTML 變化
● 反爬機制
● 瀏覽器自動化
SERP API 提供更穩定的數據獲取方式。
SERP API 和網頁爬蟲有什麼區別?
網頁爬蟲:
HTML
↓
解析
↓
數據
SERP API:
API 請求
↓
結構化 JSON
↓
數據
SERP API 可以用於 AI Agent 嗎?
可以。
它可以為 AI Agent 提供:
● 即時搜尋
● 資訊驗證
● 網路研究能力
總結
搜尋數據正在成為現代應用的重要基礎設施。
無論你正在開發:
● SEO 平台
● AI Agent
● 市場分析工具
● 自動化系統
可靠的搜尋數據都是核心能力。
傳統爬蟲適用於簡單項目,但大規模維護搜尋爬蟲系統需要投入大量工程成本。
TalorData SERP API 提供結構化搜尋結果,讓 Python 開發者無需維護複雜爬蟲基礎設施,即可快速建構搜尋驅動的應用。